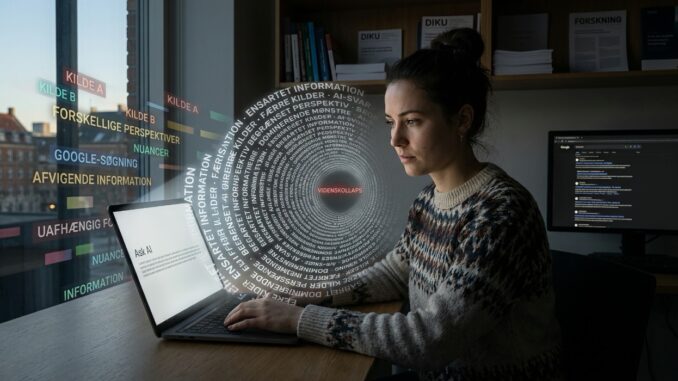
Hver gang en bruger beder en kunstig intelligens om svar på et spørgsmål, er resultatet et mere ensformigt informationsudvalg, end hvis vedkommende havde brugt en traditionel søgemaskine. Det konkluderer et nyligt offentliggjort studie udført af en række universiteter, anført af Datalogisk Institut på Københavns Universitet.
Forskerne har testet 27 store sprogmodeller fra virksomheder som OpenAI, Meta, Google og Alibaba. Undersøgelsen er baseret på 155 emner og omfatter næsten 70.000.000 udsagn genereret ud fra spørgsmål stillet af rigtige brugere. Resultaterne peger på en tydelig tendens: Selv GPT-5, som ifølge testen leverer de mest varierede svar, giver mindst 18,7% mindre mangfoldig information sammenlignet med Google.
Samtlige sprogmodeller, vi har testet, giver brugeren mere ensartet information end en simpel Google-søgning på tværs af alle de emner, vi undersøgte. Folk bliver altså i høj grad eksponeret for den samme information igen og igen. Så AI-chatbots ændrer ikke kun, hvordan vi finder viden, men også hvilken viden vi får adgang til.
Dustin Wright, tidligere adjunkt på Datalogisk Institut og nu tilknyttet Aalborg Universitet
Den manglende diversitet opstår, fordi modellerne komprimerer enorme tekstmængder og prioriterer de mest dominerende mønstre. Samtidig sorteres afvigende information fra. På sigt peger studiet på risikoen for et decideret videnskollaps, især hvis kommende generationer af kunstig intelligens i stigende grad trænes på tekst, som allerede er skabt af andre AI-modeller.
Vi risikerer, at folk bliver eksponeret for færre forskellige perspektiver og et smallere udvalg af viden. Og så kan der opstå en ond cirkel, hvor det mest populære indhold bliver endnu mere dominerende, mens andet indhold bliver mere og mere overset.
Isabelle Augenstein fra Datalogisk Institut
Selvom de nyeste AI-modeller generelt præsterer bedre på diversitet end deres ældre forgængere, opfordrer forskerne alligevel til forsigtighed i den daglige brug for ikke at blive fastlåst i et snævert perspektiv.
Selvfølgelig kan AI-chatbotters opsummeringer være nyttige – det er jo derfor, så mange bruger dem. Men det er vigtigt stadig at opsøge forskellige kilder for at forstå nuancerne og få et bredere billede – især for den yngre generation, der vokser op med AI. Vi må ikke blive så afhængige af teknologien, at vi holder op med selv at forstå og tænke.
Isabelle Augenstein fra Datalogisk Institut
Studiet fremlægges formelt på den internationale forskningskonference EMNLP i oktober 2026.
Tekniske specifikationer for undersøgelsen
- 27 analyserede store sprogmodeller fra blandt andet OpenAI, Meta, Google og Alibaba.
- 155 testede emner med tilknytning til 12 forskellige lande.
- Datagrundlaget består af 1.700.000 AI-genererede svar og omkring 70.000.000 enkeltstående udsagn.
- Mindre AI-modeller genererer ifølge studiet generelt mere diverst indhold end de største modeller på markedet.


